INFERENCEKEY

adidas · capa de inferencia con LiteLLM

Lo que a vuestro LiteLLM
todavía le falta

Modelos que no ofrece ningún proveedor, datos que no pueden salir de casa y una forma más barata de mover muchos tokens. Entra en LiteLLM como un proveedor más.

Javier Abrego · inferencekey.com

Dónde encaja

LiteLLM decide a qué modelo va cada petición.
InferenceKey le da más modelos entre los que elegir.

Vuestras apps y agentes

Copilotos, Claude Code, servicios internos

→

LiteLLM

Virtual keys, budgets, routing, fallbacks, guardrails. Se queda como está.

→
OpenAI · Anthropic · Bedrock · Vertexdatos no sensibles
ik/forecast · ik/chat-privado · ik/deepinferInferenceKey

Para LiteLLM es un proveedor más: la misma API que OpenAI y Anthropic (/v1/chat/completions, /v1/messages, embeddings, rerank, audio). No sustituye nada de lo que tenéis.

Qué es InferenceKey

Un control plane para vuestros propios modelos

GPUs vuestras o alquiladas Dentro de vuestra red Todas las modalidades Cualquier motor

Vuestras GPUs primero. La nube, solo cuando hace falta.

VUESTRAS GPUS ALQUILADAS InferenceKeycontrol plane Servidor propio Servidor propio Servidor propio Pod cloud Pod cloud

En la misma tabla: rtx6000-mad-01, GPU propia, y policy-claims-intake-H100NVL, pods alquilados en RunPod.

Modelos abiertos o propios, en vuestros servidores o en GPUs alquiladas, y todo desde el mismo panel.

GPUs vuestras o alquiladas Dentro de vuestra red Todas las modalidades Cualquier motor

El control plane también corre en vuestra red

VUESTRA RED Apps LiteLLM InferenceKeymanager GPU ✕ INTERNET · LAS LLAMADAS NO SALEN

Prompts, documentos y respuestas se quedan dentro. El despliegue on-prem completo lo validaríamos con vosotros.

GPUs vuestras o alquiladas Dentro de vuestra red Todas las modalidades Cualquier motor

Varios modelos en la misma GPU

EJEMPLO ILUSTRATIVO · 1 GPU DE 48 GB Chat22 GBEmbeddings8 GBRerank4 GBVoz6 GBForecast2 GB6 GBlibres 0 GB12 GB24 GB36 GB48 GB

Cinco workloads de modalidades distintas (transcripción, embeddings, resúmenes, imagen y rerank) servidos por la misma RTX PRO 6000.

Chat, código, embeddings, rerank, voz, imagen y forecast. Una GPU de 48 GB puede servir cinco modelos a la vez, cada uno en su parte de la memoria.
GPUs vuestras o alquiladas Dentro de vuestra red Todas las modalidades Cualquier motor

Motores abiertos, o vuestro propio código

vLLM
SGLang
llama.cpp
Ollama
Vuestro backend en Pythonempaquetado con el SDK y publicado como un modelo más

El selector de motor al crear un workload.

Se elige al desplegar. Cambiar de motor no cambia la API que ve LiteLLM.

Complementar, no reemplazar

Lo que ya tenéis y lo que os falta

LiteLLM ya lo hace

  • Virtual keys, teams y budgets
  • Routing, load balancing y fallbacks entre proveedores
  • Guardrails, caching y spend tracking por token
  • Una API para todos los proveedores

InferenceKey añade

  • Poner el modelo en marcha: GPUs, motor, servicio y recuperación ante fallos
  • Modelos que no están en ningún proveedor
  • Políticas de capacidad: scheduled, autoscaling, scale to zero
  • Lo que cuesta de verdad la GPU, por equipo, y no un precio de tarifa

Autoprovisioning

1 · Eliges2 · Se instala solo3 · Responde

Del panel a un modelo sirviendo

  • Eliges modelo, motor y servidor, y le das a crear.
  • Sin instalar nada a mano.
  • En el ejemplo, DeepSeek-V4.1-Flash: 763.000 millones de parámetros en 2 GPUs.
Real · 2 GPUs alquiladas

Autoprovisioning

1 · Eliges2 · Se instala solo3 · Responde

Se descarga, se instala y arranca solo

0 min 0 sdesde que le das a crear hasta que responde
Descarga del modelo→ Instala el motor→ Carga en las GPUs
Real · acelerado

Autoprovisioning

1 · Eliges2 · Se instala solo3 · Responde

Y responde

  • Contesta a la primera pregunta por la API compatible con OpenAI.
  • Es la misma API que usará vuestro LiteLLM.
Real · DeepSeek en 2 GPUs

Autoprovisioning desde código

Los modelos, como código en vuestro repositorio

01inference/deepseek.pymodelo, motor, GPUs y política
→
02Pull requestse revisa como cualquier otro cambio
→
03CI · ensuredeja lo que dice el código
→
04Workload sirviendoen vuestras GPUs o alquiladas
  • Queda versionado con el resto del código: se sabe quién cambió qué modelo y cuándo.
  • Idempotente: aplicarlo dos veces no duplica nada.
  • Dos credenciales: el token de SDK provisiona y nunca llama al modelo; la API key llama y no provisiona.

Autoprovisioning desde código

Con nuestro SDK open source

Apache 2.0código abierto, en GitHub
Python y TypeScriptel mismo núcleo para los dos
+30 ejemplosDeepSeek, forecast, voz, backends propios

github.com/inferencekey/inferencekey-sdk

Real · el despliegue de DeepSeek, en código

Políticas de ejecución

Cada workload decide cuándo existe su GPU

fixed scheduled autoscaling

Tres formas de decidir cuándo pagáis GPU.

fixed scheduled autoscaling

Siempre encendido

DEMANDA · PETICIONES DE CHAT GPUS ENCENDIDAS 08:0012:0016:0020:0000:0004:0008:00 2 GPUs, las 24 horas encendidas sin trabajo

Para lo interactivo, donde importa responder rápido. A cambio, también se paga de noche.

fixed scheduled autoscaling

Por ventana o por cola

JOBS EN COLA GPUS ENCENDIDAS 08:0012:0016:0020:0000:0004:0008:00 las previsiones de cada tienda entran y esperan GPU apagada 02:00 a 05:00

keep_queued · por ventana

Días y horas con zona horaria (Europe/Madrid) y mínimo y máximo de workers. Fuera de la ventana no se enciende nada.

threshold · por cola

Se enciende cuando la cola pasa de N jobs o el más antiguo supera una edad. Con 30 s sin jobs, se apaga.

Pagáis las horas de la ventana, no 730 horas al mes.

fixed scheduled autoscaling

Sigue a la demanda

DEMANDA GPUS ENCENDIDAS máximo de workers · tope de gasto por hora 08:0012:0016:0020:0000:0004:0008:00 0 GPUs · 0 coste

Sube y baja entre un mínimo y un máximo. Con mínimo 0, si no hay demanda no hay GPU. Primero se usan vuestras GPUs y después la nube.

Políticas de ejecución

Cada workload decide cuándo existe su GPU

fixed

Siempre encendido

Chat interactivo con latencia baja.

scheduled

Por ventana o por cola

Forecast nocturno, embeddings del catálogo, transcripciones.

autoscaling

Sigue a la demanda

Cargas con picos, que pueden bajar a cero.

Todas con tope de gasto por hora. Primero vuestras GPUs (coste 0), después la nube: solo las GPUs que permitís, y la más barata que haya disponible.

Autoscaling en vuestras GPUs

Llega un pico de 160 conversaciones y las GPUs pasan de 1 a 3 solas

  • Crece la cola y el autoscaler coge más workers de vuestras GPUs, sin que nadie toque nada.
  • De 1 a 3 GPUs, con tope de gasto por hora.
  • Cuando se vacía la cola, las suelta solo y el coste baja con ellas.

Scale from zero

0 GPUsLlega trabajoSe crean los podsVuelta a cero

Sin demanda, cero GPUs

  • Un workload sin GPUs propias: autoscaling de 0 a 2 workers cloud.
  • Solo las GPUs que permitís, con tope de gasto por hora.

Scale from zero

0 GPUsLlega trabajoSe crean los podsVuelta a cero

Llegan los jobs y esperan en cola

0jobs en cola

El autoscaler ve la cola y pide 2 GPUs.

Scale from zero

0 GPUsLlega trabajoSe crean los podsVuelta a cero

Crea los pods y carga el modelo

1 · Crea el pod 2 · Instala el worker con su propia identidad 3 · Carga el modelo y empieza a servir

Sin imágenes de contenedor ni Kubernetes.

Clip a 1,5x

Scale from zero

0 GPUsLlega trabajoSe crean los podsVuelta a cero

Cola vacía: vuelve a cero

JOBS EN COLA GPUS CLOUD 2 pods facturado por segundo, solo este tramo drena y apaga · 0 GPUs 0 GPUs

Lo que no se usa, no se paga.

Modelos que ningún proveedor sirve

Modelos que no encontraréis en ningún proveedor

Series temporales
AmazonGoogleSalesforceTsinghua

Chronos-2 · TimesFM 2.5 · Moirai 2 · Kronos

Demanda, ventas, inventario.

Ya desplegados
Imagen con texto
OpenMOSS · Apache 2.0

MOSS-Image-SFT

Carteles, infografías y fichas de producto con el texto bien escrito, maquetados con un JSON.

Con un backend propio, ya en nuestro SDK
Búsqueda en documentos
Illuinsobre Qweny PaliGemma

ColQwen2.5 · ColPali

Busca en PDFs y fichas técnicas a partir de la imagen de cada página, sin OCR.

Con un backend propio
Datos personales
GLiNER, open source

GLiNER PII

Detecta datos personales antes de que salgan: la pieza que necesita el guardrail.

Con un backend propio
Voz
k2-fsa

OmniVoice

Síntesis de voz con voces propias.

Ya desplegado
Lo vuestro

Modelos afinados o entrenados por vuestro equipo

Y versiones que un proveedor ya ha retirado.

Con un backend propio

Ni en OpenRouter ni en los grandes proveedores de pago por uso. Comprobado el 29-10-2026.

Ejemplo · forecast

Previsión de ventas por tienda, desde vuestro LiteLLM

  • Chronos-2, TimesFM, Moirai 2 y Kronos, desplegados hoy en nuestras GPUs.
  • Demanda, inventario, ventas por tienda o por producto.
  • En LiteLLM entran por pass-through, detrás de sus virtual keys.
  • Lo mismo con un modelo que entrene vuestro equipo de datos.
predicción → S1S2S3S4S5S6S7S8S9S10S11
ventas realesChronos-2TimesFMMoirai 2rango probable
# La misma serie a tres modelos, a través de LiteLLM
curl $LITELLM/ik/forecast/chronos2 \
  -H "Authorization: Bearer $LITELLM_KEY" \
  -d '{
    "series_id": "ventas-semanales",
    "target": [120, 135, 128, 160, 171, 158, 190],
    "horizon": 4
  }'

# /ik/forecast/timesfm  ·  /ik/forecast/moirai2

Gráfico ilustrativo: muestra la forma de la respuesta, no una salida real.

Vuestro propio código como modelo

1 · Se empaqueta2 · Se publica3 · Se sirve4 · Recibe tráfico

Empaquetáis vuestro código con el SDK

  • Un modelo de PyTorch propio y sus dependencias.
  • package_backend y publish_custom_backend: dos llamadas.

Vuestro propio código como modelo

1 · Se empaqueta2 · Se publica3 · Se sirve4 · Recibe tráfico

Queda en vuestro catálogo, versionado

  • Cada versión con su checksum: sabéis exactamente qué está sirviendo.
  • Solo lo ve vuestro tenant.

Vuestro propio código como modelo

1 · Se empaqueta2 · Se publica3 · Se sirve4 · Recibe tráfico

Se sirve como cualquier workload

  • Mismos endpoints, API keys, políticas y coste que el resto.
  • Para LiteLLM es otro ik/*.

Vuestro propio código como modelo

1 · Se empaqueta2 · Se publica3 · Se sirve4 · Recibe tráfico

Y atiende tráfico real

  • Escala con sus políticas, como los demás.
  • Versiones fijas: si un proveedor retira un modelo, el vuestro sigue.

Datos que no pueden salir

HoySiguiente paso

Lo confidencial solo va a modelos que controláis

Equipo de diseñoclave: solo ik/* ik/gemma4 · vuestra GPUresponde Modelo públicoLiteLLM lo rechaza ✓ ✕
  • Cada equipo usa su propia clave de LiteLLM.
  • La de diseño solo puede llamar a modelos ik/*, que corren en vuestras GPUs.
  • Sin plan B público: si el modelo privado se cae, la petición falla en vez de irse a otro sitio.

Por ejemplo: diseños antes del lanzamiento, datos de empleados, contratos o código propio.

Datos que no pueden salir

HoySiguiente paso

Que lo decida LiteLLM mirando el texto, no la clave

Llega una peticiónde cualquier equipo
→
Detector de datos personalesun modelo en vuestra GPU, antes de cada llamada
→
Si hay algo sensiblela bloquea, tapa esos datos o la manda solo a ik/*
  • El propio filtro es privado: el texto no sale ni para revisarlo.
  • Se engancha al guardrail que ya trae LiteLLM, en su versión open source.

Por construir: falta un adaptador pequeño entre el guardrail de LiteLLM e InferenceKey.

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

El motor de DeepSeek, abierto

  • En octubre, DeepSeek publicó DeepInfer: el motor con el que sirve su propio modelo.
  • Apache 2.0: lo mismo que hay detrás de DeepSeek, en vuestras máquinas.
  • Pero llega sin caché.

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

Llega sin caché. La caché la ponemos nosotros.

DeepInfer tal cualtodo se calcula de cero
~0 tokens/s
Con la caché de inferencekeyen la memoria de la GPU y en la RAM
~0 tokens/sunas 9 veces más

Las mismas 4 B200, con contextos de casi medio millón de tokens. Un agente relee casi todo su contexto en cada paso: eso es lo que se ahorra.

Backend de caché: open source en nuestro SDK, Apache 2.0DeepInfer: Apache 2.0

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

100 agentes a la vez, con casi medio millón de tokens cada uno

Real · datos de la prueba en 4 B200
  • La mitad empieza a responder en unos 2,5 s.
  • Ningún error.
  • El 96 % se lee desde la caché.
  • 1,8 millones de tokens por segundo de entrada y más de 2.000 de salida.

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

Y todos de golpe, sin nada en la caché

Real · datos de la prueba en 4 B200
  • 400 conversaciones de casi medio millón de tokens, a la vez.
  • 176 millones de tokens en unos 15 minutos.
  • Unos 200.000 tokens por segundo, todo leído de cero. Ningún error.

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

Menos de un céntimo por millón de tokens

Nuestra máquina4 B200, 27.900 USD/mes, a ese ritmo todo el mes
0 USD
API de DeepSeeklos mismos tokens
0 USDcasi el doble
API de Claudeprecio de lista, un mes real de Claude Code
0 USDunas 80 veces más

0,006 = 27.900 USD / (1,8 M tokens/s × 730 h). Claude y DeepSeek: el mismo mes real de Claude Code, 26.161 M tokens, 96,8 % desde caché.

Frente a 200 suscripciones Claude Max 20x (40.000 USD/mes), un 30 % menos. Con 80 usuarios tan intensivos, en cambio, la máquina sale un 75 % más cara.

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

Sin perder calidad

DeepSeek V4.1 Flashprimero de 69
0
Claude Opus 5.5
0

LiveBench, programación con agentes, 10-10-2026. En el índice general de Artificial Analysis, Claude Opus 5.5 sale por delante (58 frente a 39).

DeepInfer · agentes de código con muchos tokens

MotorCaché100 agentesEn fríoPrecioCalidadClaude Code

Claude Code, sin cambios, contra un DeepSeek privado

  • Se cambia la URL base y Claude Code no nota la diferencia.
  • Una tarea real: encuentra el fallo, lo arregla y pasan los 15 tests en 39 s.
  • Probado contra el endpoint con /v1/messages. A través de vuestro LiteLLM lo comprobaríamos en la evaluación.
Real · DeepSeek en 2 GPUs

Coste · agentes de código y cargas con mucho contexto

Cuándo compensa y cuándo no

Compensa

  • Contexto que se repite: agentes, RAG sobre el mismo catálogo, clasificación masiva.
  • Uso alto y constante, o por lotes en una ventana.
  • Datos que no pueden salir, donde la alternativa es no usar IA.

No compensa

  • Tiempo real con poco tráfico: la GPU tiene que estar siempre encendida, aunque casi no trabaje.
  • Poco volumen, o un uso tan irregular que no llega a llenar la máquina.
  • En esos casos sale más a cuenta pagar por token a un proveedor.

Coste real

Coste realGPUs propiasGPUs en la nubePor equipo

LiteLLM calcula el gasto con precios de tarifa. InferenceKey mide lo que cuesta de verdad la GPU.

  • GPUs propias y de la nube, por separado y en total.
  • Así, el precio que pongáis a cada ik/* en LiteLLM sale de datos reales.

Coste real

Coste realGPUs propiasGPUs en la nubePor equipo

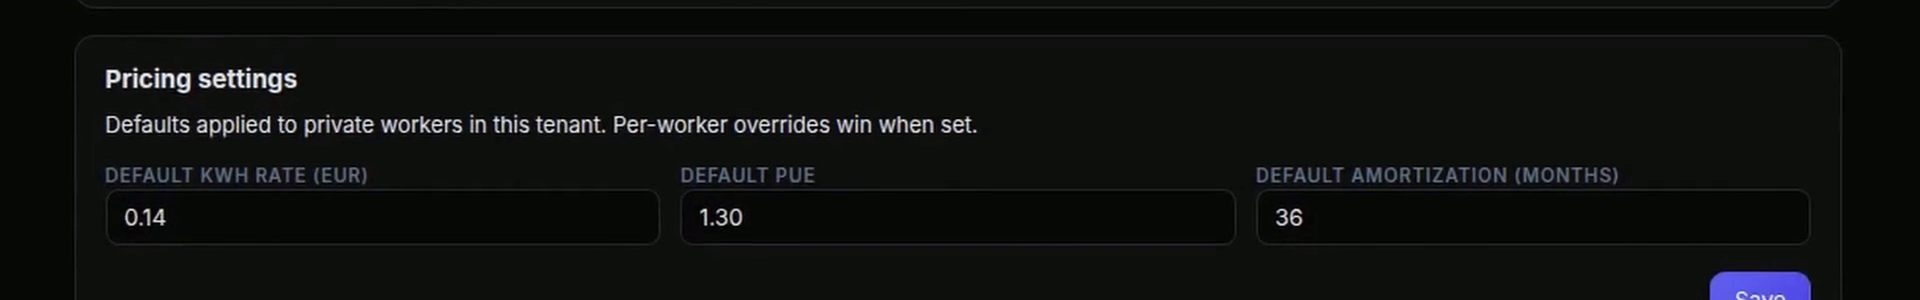
Vuestras GPUs, con su amortización

  • Compradas: el servidor se amortiza en los meses que digáis (36 por defecto).
  • Más la luz: kWh × PUE × horas encendidas, con el consumo medido.
  • Alquiladas por meses: su cuota, con todo incluido.
Ajustes de precio: kWh, PUE y meses de amortización

Coste real

Coste realGPUs propiasGPUs en la nubePor equipo

GPUs en la nube, al precio real del pod

PODS CLOUD · CADA UNO CON SU INICIO, SU FIN Y SU COSTE FINAL pod H100 NVL · 2 h 10 min pod H100 NVL · 1 h 32 min → coste final del pod → coste final del pod se paga por segundo, y nada fuera de ese tramo

Ilustrativo. Solo las GPUs que permitís y con tope de gasto por hora.

Coste real

Coste realGPUs propiasGPUs en la nubePor equipo

Cada equipo, su factura

  • Coste por proyecto, modalidad, workload y API key.
  • Acceso por workload y API key, con tokens de SDK aparte para provisionar.

La integración, en vuestro config.yaml

Una entrada en vuestro config.yaml por cada modelo

model_list:
  # Chat privado servido por InferenceKey
  - model_name: ik/gemma4-26b
    litellm_params:
      model: openai/gemma4-26b-llamacpp-amd
      api_base: https://<inferencekey>/endpoint/<proyecto>/gemma4-26b-llamacpp-amd/v1
      api_key: os.environ/IK_API_KEY

router_settings:
  # Sin fallback de privado a público: lo sensible nunca sale
  num_retries: 0

general_settings:
  pass_through_endpoints:              # forecast, detrás de la auth de LiteLLM
    - path: /ik/forecast/chronos2
      target: https://<inferencekey>/endpoint/<proyecto>/chronos2-forecast/forecast
      auth: true

Probado el 29-10 con LiteLLM 1.106.6 contra producción: chat (también en streaming), embeddings, rerank y transcripción.

Siguiente paso

¿Por dónde empezamos?

Un modelo que no encontráis

Forecast detrás de vuestro LiteLLM

Dos semanas, datos no sensibles, en modo scheduled: solo pagáis las horas de ventana.

Datos que no pueden salir

Chat privado con vuestras reglas

Un modelo privado registrado en LiteLLM y, después, el guardrail de datos personales.

La factura de tokens

Piloto con un equipo de desarrollo

Comparamos vuestra factura y experiencia actuales con DeepInfer detrás de LiteLLM: coste por persona, latencia en hora punta y tareas resueltas.

Elegid uno y en 48 horas os mandamos la propuesta por escrito.

Lo que aún no está: el despliegue on-prem completo no tiene precio ni prueba a escala, y la pantalla de costes está en inglés y en dólares.

INFERENCEKEY

Vuestro LiteLLM,
con más modelos donde elegir

Modelos que nadie más ofrece, datos que no salen de casa y GPUs que solo cuestan mientras trabajan.

inferencekey.com · docs.inferencekey.com